一些前置信息
linuxtop
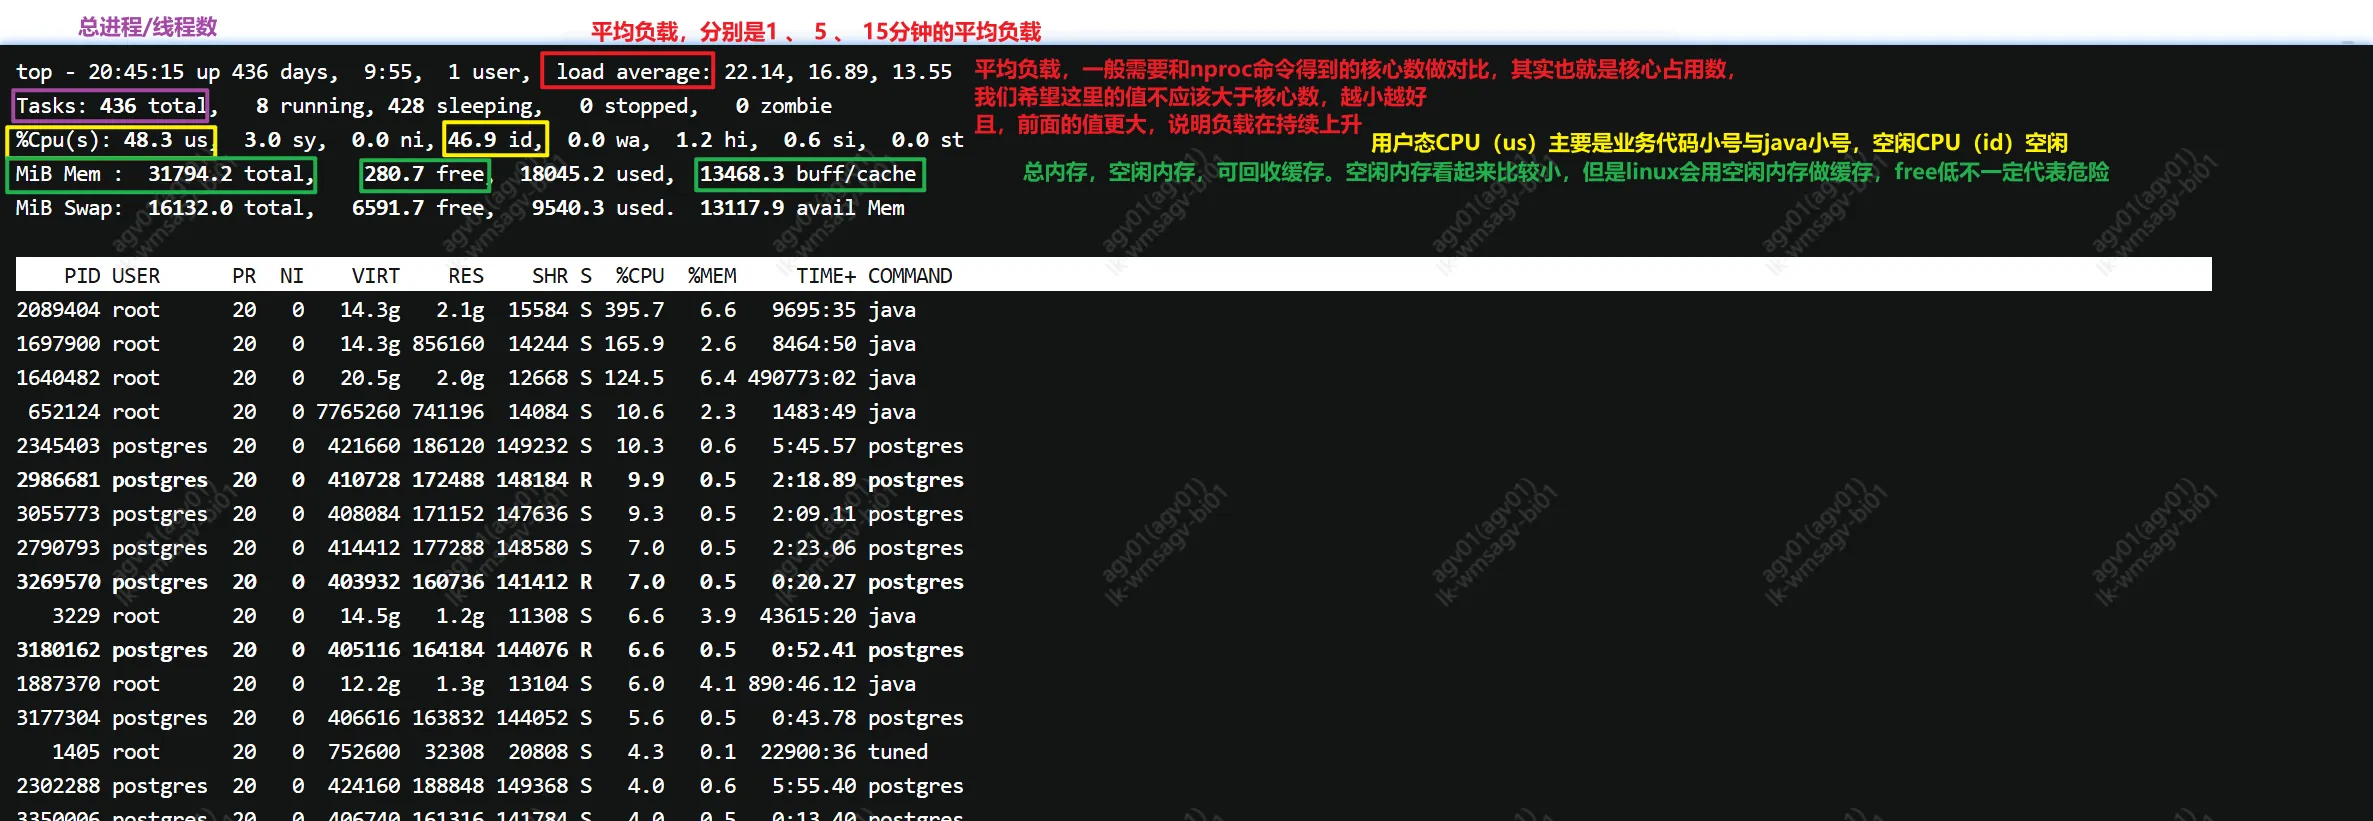
linuxps -fp 2089404(-f完整格式显示 -p指定进程id)
systemctl status machinefeeder.service
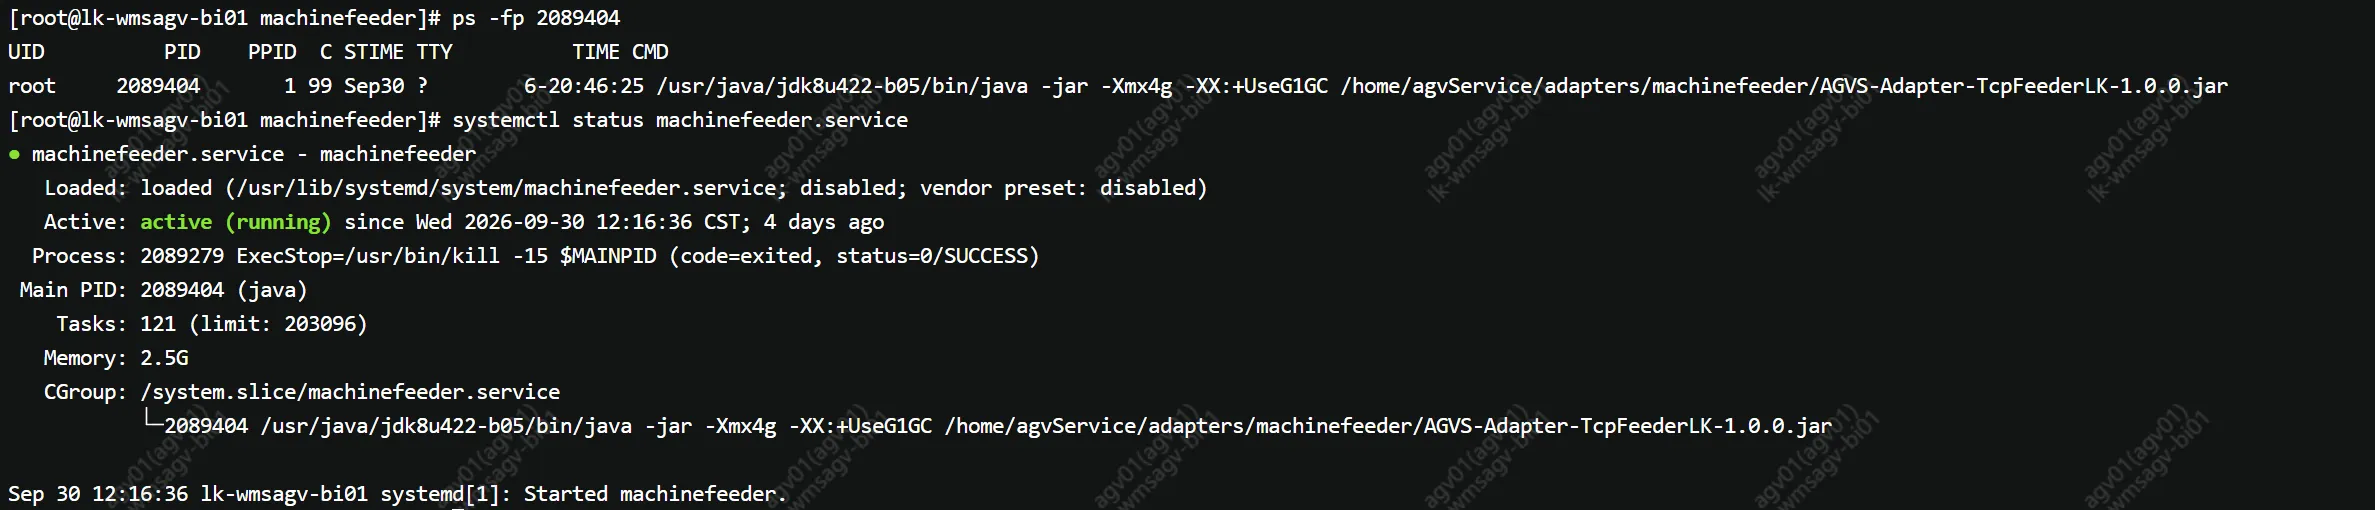
linuxdate(时间)
hostname(主机名)
uname -a(内核版本)
cat /etc/redhat-release 2>/dev/null(系统版本 2>/dev/null “2”代表标准错误>/dev/null扔进黑洞,错误不显示)
uptime(load)
nproc(逻辑CPU核心数,逻辑处理器数量而非核心数数量)
lscpu | egrep 'CPU\(s\)|Thread|Core|Socket|NUMA|Model name'
性能问题只有 3 大类:
| 类型 | 现象 | 典型原因 |
|---|---|---|
| ① CPU 型 | CPU 打满 | 死循环、GC 疯狂、密集计算 |
| ② IO 型 | CPU 空闲但服务慢 | 等网络、等数据库、等锁 |
| ③ 内存型 | 内存爆、频繁 GC | 内存泄漏、对象堆积 |
第 1 部分:通用 5 步法
任何 Java 服务排查,都走这 5 步:
第1步:top / free / vmstat    → 看系统整体,判断是"哪一类问题"
第2步:ps -ef / systemctl     → 找到是哪个服务、哪个 PID
第3步:top -Hp                → 看进程内部:是 CPU 忙还是线程在等
第4步:找 socket              → 决定 jstat/jstack 怎么跑
第5步:jstat + jmap + jstack  → 三件套,定位到具体原因
第 2 部分:第 1 步——看系统整体
命令
bashtop -bn1 | head -20
nproc
free -h
vmstat 1 5 | column -t
输出(以你的 GTLC 机器为例)
top - 14:56:41 up 227 days,  2:26,  2 users,  load average: 62.70, 71.81, 68.98
Tasks: 1231 total,   9 running, 1222 sleeping,   0 stopped,   0 zombie
%Cpu(s): 69.4 us,  3.7 sy,  0.0 ni, 26.1 id,  0.0 wa,  0.0 hi,  0.7 si,  0.0 st
KiB Mem : 26340486+total, 29020272 free, 12107215+used
逐行解读(人话版)
第 1 行:load average
| 字段 | 人话 | 判断 |
|---|---|---|
load average: 62.70, 71.81, 68.98 | 过去 1 分钟/5 分钟/15 分钟,平均有多少任务在排队 | 要除以核数! 62/112 = 0.55,其实不忙 |
第 2 行:Tasks
| 字段 | 人话 |
|---|---|
1231 total | 系统里一共 1231 个"任务"(含线程) |
9 running | 此刻有 9 个在跑 |
1222 sleeping | 1222 个在等(等 IO、等锁) |
0 zombie | 没有僵尸进程 |
第 3 行:%Cpu(s) —— 最重要
| 字段 | 人话 | 危险信号 |
|---|---|---|
us | 用户态 CPU(业务代码) | 高 = 程序在算 |
sy | 内核态 CPU(系统调用) | 高 = 频繁 IO/网络 |
id | 空闲 | 接近 0 = CPU 打满 |
wa | 等磁盘 | > 10% = 磁盘瓶颈 |
第 4~5 行:内存
| 字段 | 人话 |
|---|---|
free | 完全没用的内存 |
used | 程序用的 |
buff/cache | 内核缓存(能随时回收,不算"用了") |
判断表(关键!)
| 现象 | 判断 | 下一步方向 |
|---|---|---|
us 高 + id 低 | ① CPU 型 | 抓 jstack 看热线程 |
wa 高 | IO 瓶颈 | 查磁盘 |
id 高 + 服务慢 | ② IO 型 | 抓 jstack 看线程等在哪 |
used 高 + swap 高 | ③ 内存型 | 抓 jmap 看对象 |
GTLC 机器:
us=69.4%, id=26.1%, wa=0 → CPU 不忙,不是 CPU 型
但服务慢 → 应该是 IO 型
第 3 部分:第 2 步——找到哪个进程
命令
bash# 从 top 里看到 CPU 高的 PID
ps -ef | grep <PID>
# 或者
systemctl status <服务名>
输出
root 55832 1 0 Sep20 ? 00:19:04 /usr/lib/jvm/.../java -jar ... AGVS-Adapter-TcpWharf-1.0.0.jar
解读
| 字段 | 人话 |
|---|---|
55832 | PID |
Sep20 | 启动日期 |
AGVS-Adapter-TcpWharf-1.0.0.jar | 这就是服务名 |
-Xmx3072m -XX:+UseG1GC | 启动参数(堆最大 3G,用 G1 GC) |
记住:这一步就是"人肉搜索",把 PID 翻译成"哪个服务"。
第 4 部分:第 3 步——看进程内部(top -Hp)
命令
bashtop -Hp <PID> -bn1 | head -30
-H = 显示线程(不是进程)。-p = 只看这个 PID。
输出
Threads: 372 total,   3 running, 369 sleeping
   PID USER      %CPU   TIME+  COMMAND
 56389 root      6.2   11:44  nioEventLoopGro
 56395 root      6.2   25:36  nioEventLoopGro
 56398 root      6.2   12:32  nioEventLoopGro
 55832 root      0.0    0:00  java
 ...
解读
| 字段 | 人话 |
|---|---|
Threads: 372 total | 这个进程有 372 个线程 |
3 running | 只有 3 个在跑 |
%CPU | 每个线程占的 CPU(100% = 1 核) |
COMMAND | 线程名(Java 里给线程起的名字) |
关键判断
看最高 %CPU 的线程:
| 现象 | 含义 |
|---|---|
| 有线程 %CPU 接近 100 | 热线程——它在死循环/密集计算 |
| 所有线程 %CPU 都很低 | 不是 CPU 问题——线程在等 |
你的 GTLC:
最高才 6.2% —— 没有热线程
=> 是"等"型问题,不是"算"型
你的 httpmt(同一位置):
没看,但从 CPU 1048% 看,肯定有热线程
第 5 部分:第 4 步——找 socket
为什么要找
jstat / jstack 不是"读取内存",是"通过 socket 和 JVM 通信"。
如果 socket 找不到,jstat/jstack 会报 not found。
命令
bash# 看 socket 在不在
ls -la /tmp/.java_pid<PID>                         # 公共 /tmp
ls -la /proc/<PID>/root/tmp/.java_pid<PID>         # 进程私有的 /tmp
输出
srw------- 1 root root 0 Oct 6 23:15 /proc/1697900/root/tmp/.java_pid1697900
解读
| 特征 | 含义 |
|---|---|
第一个字符是 s | 这是 socket(不是普通文件) |
权限 srw------- | 只有 root 能读写 |
| 文件名带 PID | JVM 用 PID 区分不同的进程 |
两种结果,决定两种 jstat 写法
| 哪条有输出 | jstat 写法 |
|---|---|
| 公共 /tmp 有 | 直接 jstat -gcutil <PID> 1000 5 |
| 只有私有 /tmp 有 | nsenter -t <PID> -m --preserve-credentials jstat -gcutil <PID> 1000 5 |
你的 1697900:socket 在私有 /tmp → 必须用 nsenter。
第 6 部分:第 5 步——三件套
6.1 jstat —— 看 GC 状态
命令:
bashnsenter -t <PID> -m --preserve-credentials \
  /usr/java/jdk8u422-b05/bin/jstat -gcutil <PID> 1000 5
格式:jstat -gcutil <PID> <间隔毫秒> <次数>
输出:
  S0     S1     E      O      M     CCS    YGC     YGCT    FGC    FGCT     GCT
  0.00 100.00  13.20  84.85  93.80  89.70 1128140 8445.637  0    0.000  8445.637
  0.00 100.00  26.00  84.85  93.80  89.70 1128141 8445.645  0    0.000  8445.645
逐列解读:
| 列 | 全称 | 人话 | 危险 |
|---|---|---|---|
S0 S1 | Survivor 0/1 | 新生代"过渡房" | — |
E | Eden | 新生代"新生儿房" | 涨得快 = 对象创建快 |
O | Old | 老年代"老年公寓" | > 90% 危险 |
M | Metaspace | 类信息区 | — |
CCS | 压缩类空间 | — | — |
YGC | Young GC 次数 | 小扫除次数 | 增长快 = 频繁 |
YGCT | Young GC 时间 | 累计耗时(秒) | — |
FGC | Full GC 次数 | 大扫除次数 | 增长 = 严重 |
FGCT | Full GC 时间 | 累计耗时(秒) | — |
GCT | GC 总时间 | YGCT + FGCT | 占运行时间 > 5% = 有问题 |
你的 1697900:
| 指标 | 值 | 判断 |
|---|---|---|
O=84.85% | 老年代偏高 | 但不失控 |
YGC=1128140 | 8 天做了 112 万次 | 每秒 1.5 次,很频繁 |
FGC=0 | 没 Full GC | 还没到灾难 |
GCT=8445秒 | 占运行时间 1.16% | 正常 |
结论:高频 Young GC,但还没崩。
6.2 jmap -histo —— 看对象分布
命令:
bashnsenter -t <PID> -m --preserve-credentials \
  /usr/java/jdk8u422-b05/bin/jmap -histo <PID> | head -30
输出:
 num     #instances   #bytes   class name
 1:      263516      131MB    [I                              ← int 数组
 2:      2129024     129MB    [C                              ← char 数组
 7:      258858      28MB     io.netty.channel.socket.nio.NioSocketChannel   ← ⚠️ TCP 连接
解读:
| 字段 | 人话 |
|---|---|
num | 排名 |
#instances | 这个类有多少个实例 |
#bytes | 这些实例占的总字节 |
class name | 类名(能看出是什么东西) |
关键:看谁排第一、谁的"实例数"异常大。
你的 1697900:
258,858 个 NioSocketChannel ← 25 万个 TCP 连接对象
一台机器怎么可能有 25 万个 TCP 连接? → 泄漏了。
你的 httpmt:
751 万个 FutureTask          ← 751 万个"待执行任务"
751 万个 LinkedBlockingQueue$Node
怎么会有 751 万个任务? → 堆积了。
6.3 jstack —— 看线程栈
命令:
bashnsenter -t <PID> -m --preserve-credentials \
  /usr/java/jdk8u422-b05/bin/jstack <PID> > /tmp/xxx_jstack.txt
输出(一个线程块):
"pool-2-thread-1" #35 prio=5 ... runnable
   java.lang.Thread.State: RUNNABLE
        at com.vlinkplus...httpHandler.httpGet(httpHandler.java:261)
        at com.vlinkplus...httpHandler.readStatus(httpHandler.java:76)
        at com.vlinkplus...httpHandler.lambda$doJob$0(httpHandler.java:48)
        ...
逐段解读:
| 部分 | 人话 |
|---|---|
"pool-2-thread-1" | 线程名(能看出是哪个池) |
Thread.State: RUNNABLE | 状态:正在跑 |
at com.vlinkplus...httpGet | 栈顶:此刻卡在哪个方法 |
at ...readStatus | 是被谁调用的 |
at ...doJob | 再往上 |
栈要从下往上读:
doJob()  ← 源头
  ↓
readStatus()  ← 中间层
  ↓
httpGet()  ← 此刻卡在这
线程状态表:
| 状态 | 含义 |
|---|---|
RUNNABLE | 正在跑 / 等 IO |
WAITING (parking) | 无限等(线程池空闲) |
TIMED_WAITING | 有超时的等 |
BLOCKED | 等锁 |
第 7 部分:三种典型问题的完整路径
🅰 类型 1:IO 阻塞型(GTLC)
症状:
- CPU 不忙(
id=26%) - 但服务慢
- 大量线程在 sleeping
命令链:
bash# 1. top 看到 CPU 不忙
top -bn1 | head -20
# → us=69%, wa=0%, id=26%

# 2. 找 PID 和线程状态
top -Hp 55832 -bn1 | head -30
# → 最高才 6.2%,没有热线程 → 是"等"型

# 3. 找 socket,然后 jstack
nsenter -t 55832 -m --preserve-credentials jstack 55832 > /tmp/js1.txt

# 4. 统计线程名分布
grep '^"' /tmp/js1.txt | sed 's/" #.*//' | sed 's/-[0-9]*$//' | sort | uniq -c | sort -rn
# → 110 个 pool-3-thread

# 5. 统计栈顶方法
awk '/^"/ { in_thread=1; found=0; next } /^\s+at / { if (in_thread && !found) { sub(/^\s+at /, ""); print; found=1 } }' /tmp/js1.txt | sort | uniq -c | sort -rn | head
# → 71 个 Unsafe.park, 43 个 Object.wait, 38 个 socketRead0
定位到:TcpUtil.sendMsg:189 里用了 .sync()(无超时同步等待),HttpApiUtil.get:374 里用了 .execute()(50 秒超时),池子是 newCachedThreadPool(无上限)。
修法:改异步、缩短超时、改有界池。
🅱 类型 2:连接泄漏型(machinefeeder / feederadapter)
症状:
- CPU 高
- 内存持续增长
- 有大量
Gang worker(G1 GC 线程)在忙
命令链:
bash# 1. top 看到 CPU 高
top -bn1 | head -20
# → us=91.8%

# 2. 找 PID
ps -ef | grep 3968899
# → AGVS-Adapter-TcpFeederLK-1.0.0.jar

# 3. jstat 看 GC
jstat -gcutil 3968899 1000 10
# → YGC=119万, FGC=0, O=88%(G1 并发标记在忙)

# 4. jmap -histo 看对象
jmap -histo 3968899 | head -30
# → 121 万 NioSocketChannel ⚠️
# → 121 万 SocketChannelImpl
# → 121 万 ReadTimeoutHandler

# 5. jstack 看线程(可选,看有没有卡点)
定位到:TcpUtil.connect 连接失败分支没有 future1.channel().close(),每次失败重连就泄漏一个 channel。
修法:失败分支加 close() + 指数退避。
🅲 类型 3:任务堆积型(httpmt)
症状:
- CPU 高
- 有大量
Gang worker - Full GC 疯狂跑
命令链:
bash# 1. top
top -bn1 | head -20
# → us=88%

# 2. 找 PID
ps -ef | grep 4060618
# → AGVS-Adapter-ModbusTcpMaster-1.0.0.jar

# 3. jstat 看 GC
jstat -gcutil 4060618 1000 5
# → FGC=10336 次,FGCT=81927 秒,O=99.99%
# → Full GC 跑了 22 小时!

# 4. jmap -histo
jmap -histo 4060618 | head -30
# → 751 万 FutureTask
# → 751 万 LinkedBlockingQueue$Node
# → 751 万 httpHandler$$Lambda

# 5. jstack
jstack 4060618 > /tmp/httpmt_jstack.txt
# → pool-2-thread-1 卡在 httpHandler.httpGet(httpHandler.java:261)
定位到:doJob() 每 100ms 提交任务,只有 1 个线程消费,队列无界 → 任务堆到 751 万。
修法:降频 + 有界队列 + HTTP 加超时。
第 8 部分:一句话对照表
把三种问题放在一起对照:
| 🅰 IO 型 | 🅱 连接泄漏 | 🅲 任务堆积 | |
|---|---|---|---|
| 症状 | CPU 不忙,服务慢 | CPU 高,G1 忙 | CPU 高,Full GC 忙 |
| jstat | YGC 正常,FGC=0 | YGC 多,FGC=0 | FGC 疯狂涨 |
| jmap | 对象正常 | NioSocketChannel 多 | FutureTask 多 |
| jstack | 大量 waiting | — | 卡在某个方法 |
| 根因 | 同步阻塞 + 无超时 | 失败不 close() | 提交快 + 消费慢 |
| 修法 | 改异步 + 超时 | 加 close() | 降频 + 有界队列 |
第 9 部分:你能记住的"底层套路"
所有排查,都是这个流程:
1. 看整体(top)→ 判断是 CPU型/IO型/内存型
2. 找 PID(ps)
3. 看内部(top -Hp)→ 是热线程还是全在等
4. 找 socket → 决定 jstack/jstat 怎么跑
5. 三件套:
   - jstat 看 GC(大方向)
   - jmap 看对象(谁在堆积)
   - jstack 看线程(谁在等/谁在忙)
6. 看源码 → 定位根因
同一个套路,三种问题都适用。
第 10 部分:给你的"笔记整理建议"
用这个格式记:
markdown## 案例:<服务名> —— <一句话问题>

### 1. 症状
- top 里看到:<填>
- 判断类型:<CPU型/IO型/内存型>

### 2. 排查命令链
| 步骤 | 命令 | 看到什么 | 说明 |
|---|---|---|---|
| 1 | top | ... | ... |
| 2 | ps -ef | ... | ... |
| 3 | jstat | ... | ... |
| 4 | jmap -histo | ... | ... |
| 5 | jstack | ... | ... |

### 3. 定位结果
- 根因:<填>
- 文件位置:<填>

### 4. 修复方案
- P0:<填>
- P1:<填>
完整流程 + 命令 + 输出解读
我按你说的流程,把每一步的命令、输出、怎么分析都列出来。
第一步:top —— 找到 CPU 高的进程
命令
bashtop -bn1 | head -20
输出
%Cpu(s): 88.5 us,  3.4 sy,  0.0 ni,  6.5 id,  0.0 wa
    PID USER      %CPU %MEM     TIME+  COMMAND
4060618 root      1048 14.5   2119:20  java
1640482 root      166  11.2   488394:08 java
分析
| 看什么 | 判断 |
|---|---|
%Cpu(s) 的 id | 接近 0 = CPU 打满 |
%Cpu(s) 的 wa | >10% = 磁盘瓶颈 |
下半部分 %CPU 列 | 找数值大的 PID |
拿到 PID = 4060618,进入下一步。
第二步:ps -ef —— 确认是哪个服务
命令
bashps -o pid,stat,etime,pcpu,pmem,nlwp,cmd -p <PID>
输出
    PID STAT     ELAPSED %CPU %MEM   RSS NLWP CMD
4060618 Ssl   6-01:05:43  437 14.5 4735272 113 /usr/java/.../java -jar -Xmx4g ... ModbusTcpMaster-1.0.0.jar
分析
| 字段 | 含义 |
|---|---|
ELAPSED | 运行多久(6 天) |
%CPU | 437%(≈4 核) |
NLWP | 113 个线程 |
CMD | 这就是服务名——找到 ModbusTcpMaster-1.0.0.jar |
可选:systemctl status <服务名> 看服务状态和重启历史。
第三步:top -Hp —— 看进程内部哪个线程高
命令
bashtop -Hp <PID> -bn1 | head -30
输出(两种情况)
情况 A:有热线程
Threads: 113 total,  32 running,  81 sleeping
    PID USER      %CPU   TIME+   COMMAND
3968929 root      32.0   2119:20  Gang worker#0
3968930 root      28.0   2118:47  Gang worker#1
3969202 root      23.0   929:27   nioEventLoopGro
情况 B:没有热线程
Threads: 372 total,   3 running, 369 sleeping
    PID USER      %CPU   TIME+   COMMAND
 56389 root      6.2   11:44  nioEventLoopGro
 56395 root      6.2   25:36  nioEventLoopGro
 55832 root      0.0    0:00  java
(其余线程几乎 0%)
分析:先看线程名,再看数值
| 线程名 | 是什么 | 走哪条路 |
|---|---|---|
pool-x-thread-y | 业务线程池 | 走 jstack |
nioEventLoopGroup-x | Netty IO 线程 | 走 jstack |
http-nio-xxx | Tomcat 请求线程 | 走 jstack |
Gang worker#x | G1 GC 线程 | 走 jstat |
GC task thread#x | Parallel GC 线程 | 走 jstat |
| 数值 | 判断 |
|---|---|
| 某个线程 %CPU 接近 100 | 有热线程 |
| 所有线程都低(<10%) | 无热线程 |
两条路
- 有业务热线程 → 直接 jstack
- 有 GC 热线程 / 无热线程 → 走 jstat
第四步 A:jstack —— 有业务热线程时
命令
bash# 先确认 socket 位置
ls -la /proc/<PID>/root/tmp/.java_pid<PID>
ls -la /tmp/.java_pid<PID>

# 如果 socket 在私有 /tmp(第一条有,第二条没有)
nsenter -t <PID> -m --preserve-credentials \
  /usr/java/jdk8u422-b05/bin/jstack <PID> > /tmp/xxx_jstack.txt

# 如果 socket 在公共 /tmp
jstack <PID> > /tmp/xxx_jstack.txt
输出(关键的一段)
"pool-2-thread-1" #35 prio=5 ... runnable
   java.lang.Thread.State: RUNNABLE
        at com.vlinkplus...httpHandler.httpGet(httpHandler.java:261)
        at com.vlinkplus...httpHandler.readStatus(httpHandler.java:76)
        at com.vlinkplus...httpHandler.lambda$doJob$0(httpHandler.java:48)
        at java.util.concurrent.ThreadPoolExecutor.runWorker(...)
        at java.lang.Thread.run(Thread.java:750)
分析
| 看什么 | 含义 |
|---|---|
| 线程名 | 属于哪个池 |
Thread.State | RUNNABLE / WAITING / BLOCKED |
栈顶 at ... | 此刻卡在哪一行代码 |
栈要从下往上读:
Thread.run ← 起点
    ↓
ThreadPoolExecutor.runWorker ← 线程池调度
    ↓
doJob → readStatus → httpGet  ← 此刻卡在这
定位结果:问题出在 httpGet(httpHandler.java:261)。
第四步 B:jstat —— 无热线程时
命令
bash# 私有的
nsenter -t <PID> -m --preserve-credentials \
  /usr/java/jdk8u422-b05/bin/jstat -gcutil <PID> 1000 5

# 公共的
jstat -gcutil <PID> 1000 5
格式:jstat -gcutil <PID> <间隔毫秒> <次数> = 每 1 秒采一次,共 5 次。
输出
  S0     S1     E      O      M     CCS    YGC     YGCT    FGC    FGCT     GCT
  0.00 100.00  13.20  84.85  93.80  89.70 1128140 8445.637  0    0.000  8445.637
  0.00 100.00  26.00  84.85  93.80  89.70 1128141 8445.645  0    0.000  8445.645
  0.00 100.00  38.55  84.85  93.80  89.70 1128142 8445.654  0    0.000  8445.654
  0.00 100.00  51.23  84.85  93.80  89.70 1128143 8445.664  0    0.000  8445.664
  0.00 100.00  63.78  84.85  93.80  89.70 1128144 8445.677  0    0.000  8445.677
分析
| 列 | 含义 | 危险信号 |
|---|---|---|
E | Eden 使用率 | 涨得快 = 对象创建快 |
O | 老年代使用率 | >90% 危险 |
YGC | Young GC 次数 | 增长快 = 频繁 |
YGCT | Young GC 总耗时(秒) | — |
FGC | Full GC 次数 | 增长 = 严重 |
FGCT | Full GC 总耗时 | >几秒 = 严重 |
GCT | GC 总耗时 | 占运行时间 >5% 有问题 |
3 种典型结果:
| 现象 | 判断 | 下一步 |
|---|---|---|
FGC 涨得快 / FGCT 大 | Full GC 疯狂 | 走 jmap |
YGC 涨得快(每秒 >3 次)/ O 高 | 对象创建快 / 老年代满 | 走 jmap |
YGC/FGC 都正常,O 低 | GC 正常 | 走 jstack |
第五步:jmap —— GC 忙时看堆
命令
bashnsenter -t <PID> -m --preserve-credentials \
  /usr/java/jdk8u422-b05/bin/jmap -histo <PID> | head -30
输出
 num     #instances   #bytes   class name
 1:      7514121      240MB    java.util.concurrent.FutureTask
 2:      7514180      180MB    java.util.concurrent.Executors$RunnableAdapter
 3:      7514123      180MB    java.util.concurrent.LinkedBlockingQueue$Node
 4:      7514121      180MB    com.vlinkplus...httpHandler$$Lambda$660/...
 5:      258858       28MB     io.netty.channel.socket.nio.NioSocketChannel
分析
| 字段 | 含义 |
|---|---|
#instances | 这个类有多少个实例 |
#bytes | 总字节数 |
class name | 类名 |
看排前几名的:
| 看到什么 | 判断 |
|---|---|
NioSocketChannel 特别多 | 连接泄漏 |
FutureTask / LinkedBlockingQueue$Node 多 | 任务堆积 |
| 某个业务类特别多 | 内存泄漏 |
[B / [C(byte/char 数组)多 | 可能是 String 或大对象 |
几个对象算是"多"?
| 服务规模 | 正常 | 异常 |
|---|---|---|
| 小服务(几十线程) | 几万 | > 50 万 |
| 中服务(几百线程) | 几十万 | > 100 万 |
| 大服务(上千线程) | 几百万 | > 500 万 |
结合业务判断:NioSocketChannel 应该 ≈ 设备数(几十到几百),不是 121 万。
第六步(可选):看源码定位根因
看 jstack 的栈或 jmap 里异常的对象名,去源码找对应的方法。
比如:
TcpUtil.sendMsg用了.sync()→ 找TcpUtil.java:189httpHandler.httpGet→ 找httpHandler.java:261
你问的最后一个问题:没有热线程 + GC 也不忙,会是什么?
会的,有 3 种情况:
情况 1:IO 阻塞型(最常见)
特征:
top -Hp里所有线程都睡jstat显示 GC 正常jstack里线程卡在WAITING/socketRead/Object.wait
判断:
- CPU 不忙 = 没人算
- GC 不忙 = 没有垃圾问题
- 线程都在等 = 等外部(网络/DB/锁)
例子:案例 1 GTLC —— 110 个线程卡在 TcpUtil.sendMsg 的 .sync()。
行动:用 jstack 找出"线程在等什么",改异步/加超时。
情况 2:瞬时爆发型
特征:
- 你采样时 CPU 已经降下来
top时高时低jstat显示 GC 正常jstack看线程正常
原因:CPU 高是"脉冲式"的,你采样时刚好没赶上。
行动:
- 多采几次(
vmstat 1 30看 30 秒) - 用
top -d 1持续观察 - 用
pidstat -u 1 10 <PID>看历史
情况 3:内核态忙
特征:
sy高(不是us)- 应用线程不忙
cs(上下文切换)特别高
原因:
- 网络协议栈忙
- 系统调用频繁
- 线程切换频繁
行动:
ss -s看连接数vmstat看cs/inperf top -p <PID>看内核热点
完整流程图(你可以抄下来)
【第 1 步】top -bn1 | head -20
   → 找 CPU 高的 PID

【第 2 步】ps -o pid,stat,etime,pcpu,pmem,nlwp,cmd -p <PID>
   → 确认服务名

【第 3 步】top -Hp <PID> -bn1 | head -30
   → 看线程
   │
   ├─ 有热线程
   │   │
   │   ├─ 名字是业务线程(pool-x、nioEventLoop、http-nio)
   │   │   → 【第 4 步 A】jstack 看栈
   │   │
   │   └─ 名字是 GC 线程(Gang worker、GC task)
   │       → 【第 4 步 B】jstat 看 GC
   │
   └─ 无热线程
       → 【第 4 步 B】jstat 看 GC

【第 4 步 A】jstack
   → 看到底卡在哪一行代码
   → 看源码找根因

【第 4 步 B】jstat -gcutil <PID> 1000 5
   → 看 FGC/YGC/O
   │
   ├─ FGC 涨 / YGC 快 / O 高
   │   → 【第 5 步】jmap -histo
   │
   └─ 都正常
       → 是"IO 阻塞型"或"瞬时爆发型"
       → 【第 4 步 A】jstack 看线程在等什么

【第 5 步】jmap -histo <PID> | head -30
   → 看什么对象堆在堆里
   → 看源码找根因
最后:三种"无热线程 + GC 不忙"的总结表
| 类型 | 特征 | 下一步 |
|---|---|---|
| IO 阻塞 | jstack 里线程卡在 WAITING / Object.wait | 看 jstack,找卡点 |
| 瞬时爆发 | top 时高时低,采样没赶上 | 多采几次 |
| 内核态忙 | sy 高 + cs 高 | ss -s / perf top |
案例 1(GTLC)就是第一种:CPU 不忙、GC 正常、线程全卡在 .sync()。
总结:你要记的
| 步骤 | 命令 | 目的 |
|---|---|---|
| 1 | top -bn1 | head -20 | 找 CPU 高的 PID |
| 2 | ps -o ... -p <PID> | 确认服务名 |
| 3 | top -Hp <PID> -bn1 | head -30 | 看线程 + 看名字 |
| 4A | jstack <PID> | 业务热线程 → 看栈 |
| 4B | jstat -gcutil <PID> 1000 5 | 无热线程 → 看 GC |
| 5 | jmap -histo <PID> | head -30 | GC 忙 → 看对象 |
记住这三句:
- 有业务热线程 → jstack
- 有 GC 热线程 / 无热线程 → jstat
- jstat 显示 GC 忙 → jmap